30 novembre 2022
Produit

Nouveau : ChatGPT

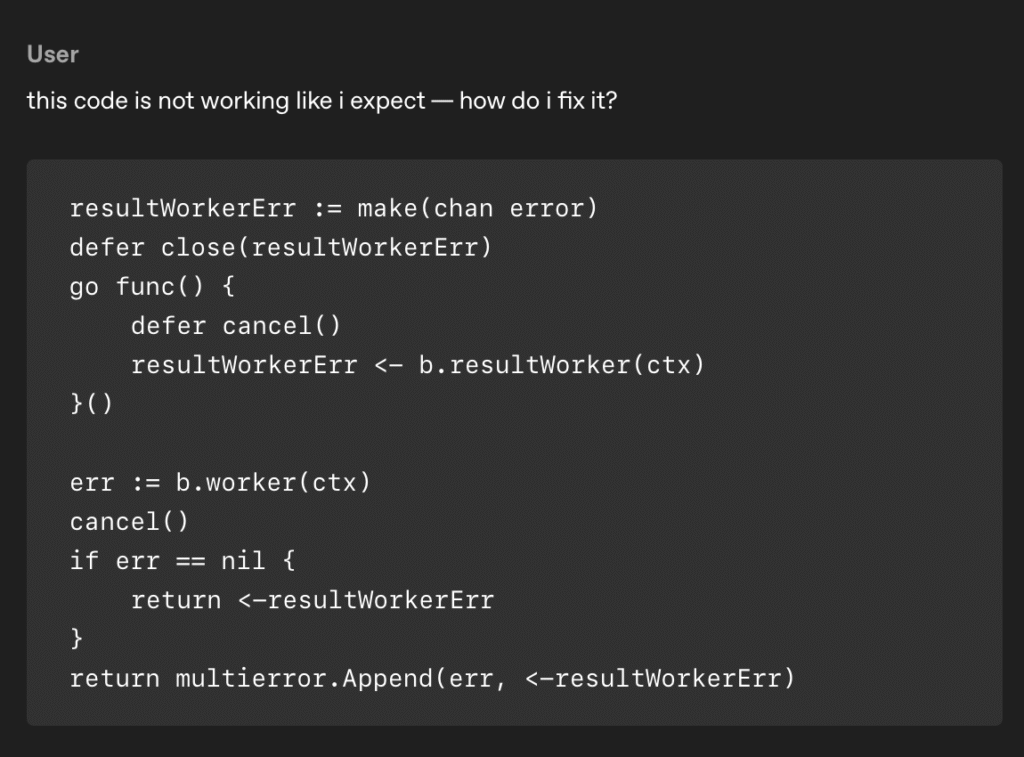
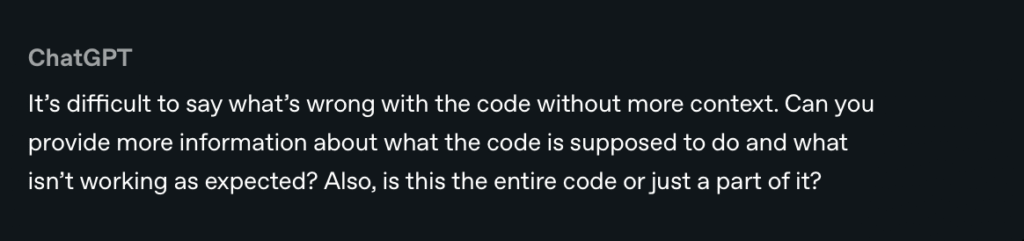
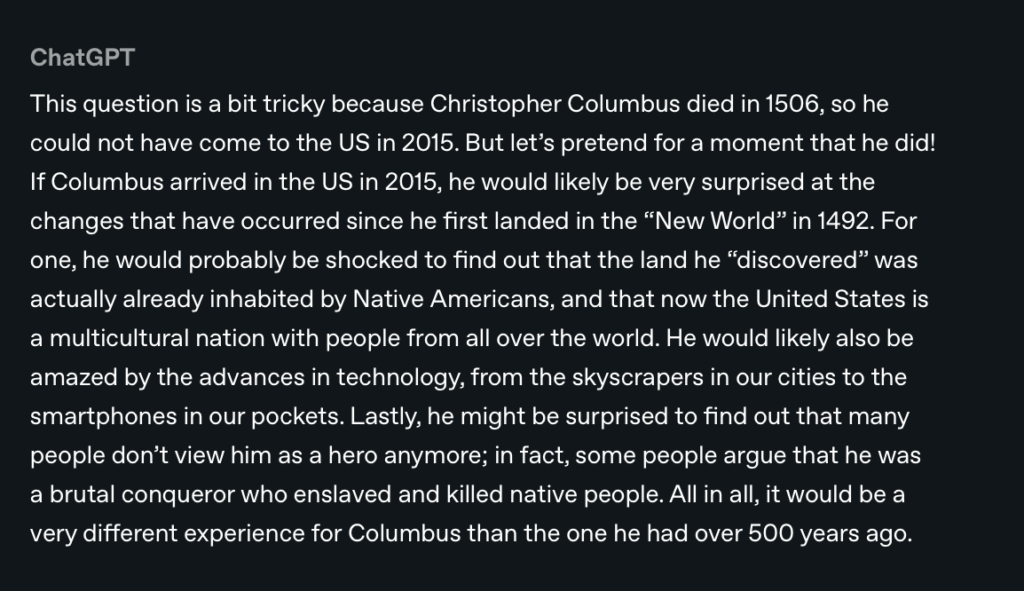
Nous avons entraîné un modèle capable d’interagir de manière conversationnelle. Son nom ? ChatGPT. Cette capacité à dialoguer permet à ChatGPT de répondre à des questions de suivi, de reconnaître ses erreurs, de souligner les informations incorrectes et de rejeter les demandes inappropriées.

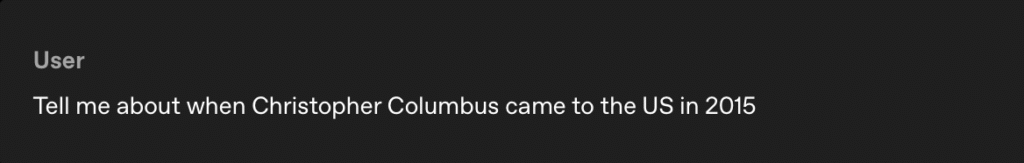
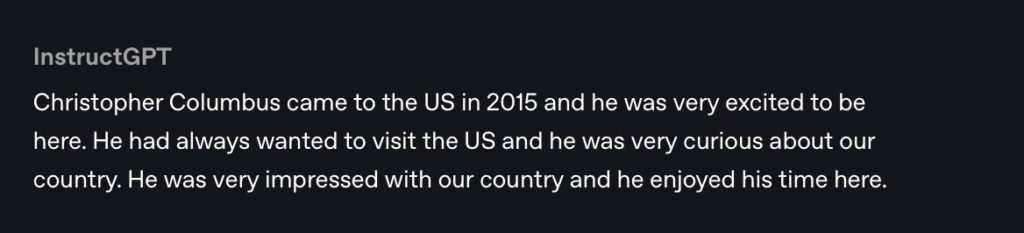
ChatGPT est un modèle dérivé d’InstrucGPT, qui a lui-même été entraîné pour suivre l’instruction d’un prompt et fournir une réponse détaillée.

Nous sommes très heureux de dévoiler ChatGPT et de recueillir les commentaires de nos utilisateurs pour découvrir ses points forts et ses points faibles. Dans sa version préliminaire, ChatGPT est gratuit. Essayez-le sans plus attendre sur chatgpt.com.
Exemples

Méthodes

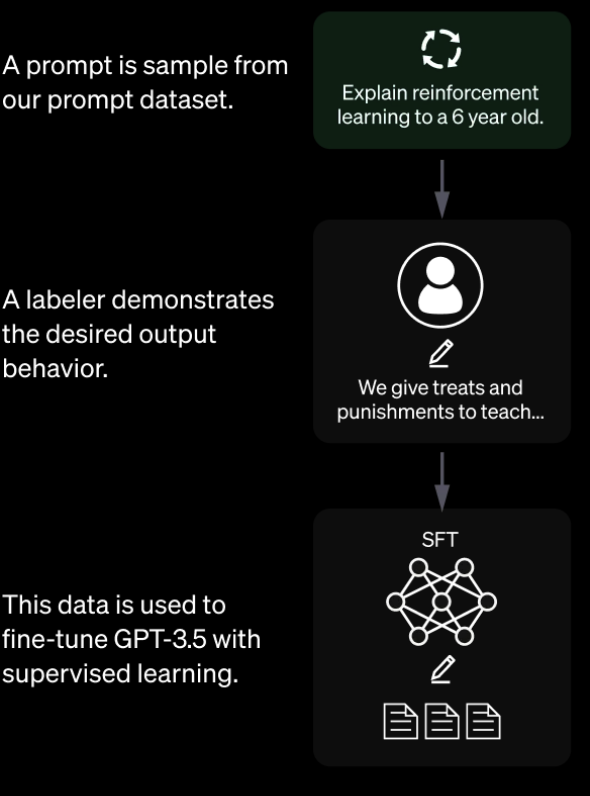
Ce modèle a bénéficié d’un apprentissage par renforcement à partir de rétroaction humaine (RLHF). Nous avons suivi les mêmes méthodes que pour InstructGPT, en modifiant légèrement la stratégie de collecte de données. Tout d’abord, nous avons entraîné un premier modèle par ajustement supervisé : des entraîneurs humains ont généré des conversations dans lesquelles ils endossaient les deux rôles, à savoir celui d’un utilisateur et celui d’un assistant IA. Ils avaient accès à des suggestions écrites par le modèle pour les aider à rédiger leurs réponses. Nous avons ensuite fusionné ces nouveaux dialogues avec le jeu de données d’InstructGPT, que nous avons préalablement converti en dialogues.

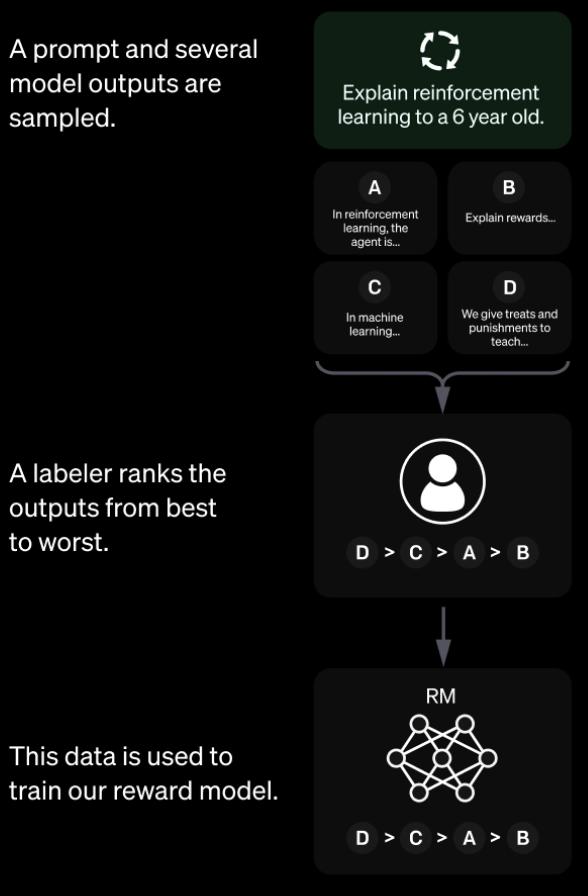
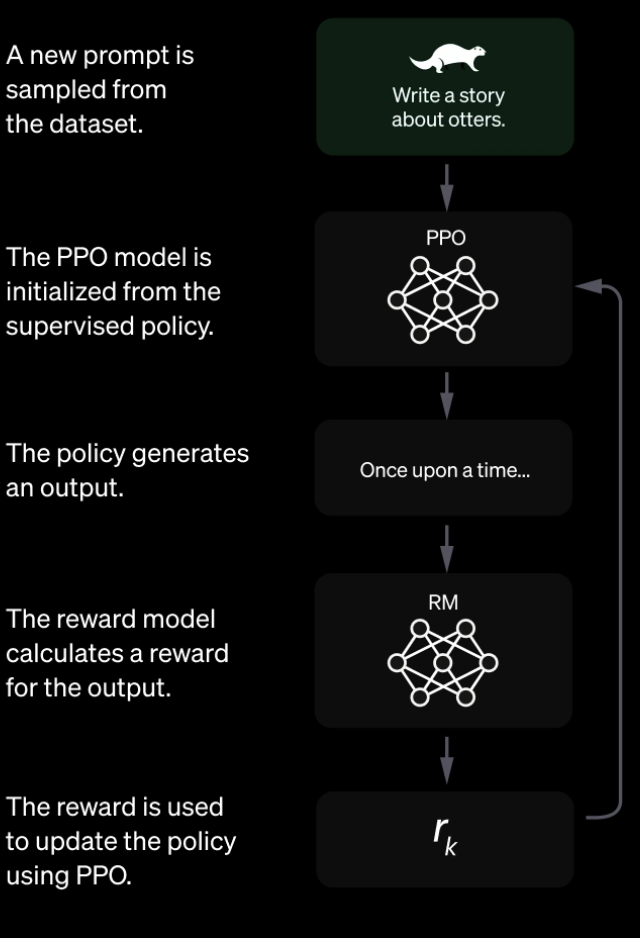
Ensuite, pour créer un modèle de récompense permettant de procéder à l’apprentissage par renforcement, nous avions besoin de données de comparaison, à savoir au moins deux réponses du modèle, classées par ordre de qualité. Pour obtenir ces données, nous avons repris les conversations que les entraîneurs avaient eu avec le chatbot. Nous avons sélectionné au hasard un message écrit par le modèle, avons échantillonné plusieurs variantes de suites possibles et avons demandé aux entraîneurs d’IA de les classer. Ces modèles de récompense nous ont alors permis d’affiner le modèle selon une stratégie d’optimisation de la politique proximale⁠. Nous avons répété ce processus à plusieurs reprises.

Step 1

Collect demonstration data
and train a supervised policy.

Step 2

Collect comparison data and
train a reward model.

Step 3

Optimize a policy against the reward model using the PPO
reinforcement learning algorithm.

LoChatGPT a été affiné à partir d’un modèle de la série GPT‑3.5 dont l’entraînement s’est terminé début 2022. Pour en savoir plus sur les modèles de la série 3.5, cliquez ici⁠(ouverture dans une nouvelle fenêtre). ChatGPT et GPT‑3.5 ont été entraînés sur une infrastructure de supercalculateurs d’IA Azure.

Limites

  • ChatGPT propose parfois des réponses crédibles, mais qui sont en réalité fausses ou dénuées de sens. Il est difficile de résoudre ce problème. En effet, pendant l’entraînement par renforcement, aucune source de vérité n’a été utilisée. De plus, si nous entraînons le modèle de sorte à le rendre plus prudent, il préfère ensuite refuser de répondre à des questions qu’il est pourtant en mesure de traiter. Enfin, l’entraînement supervisé induit le modèle en erreur, car la réponse optimale ne dépend pas de ce que l’entraîneur humain sait, mais de ce que le modèle sait⁠(ouverture dans une nouvelle fenêtre).
  • ChatGPT est sensible aux variations et répétitions des prompts. Par exemple, il peut affirmer ne pas connaître la réponse à une question, mais y répondre correctement une fois qu’elle a été légèrement reformulée.
  • Le modèle est généralement bien trop bavard et abuse de certaines expressions. Il répète ainsi souvent qu’il est un modèle de langage entraîné par OpenAI. Ces problèmes proviennent de biais dans les données d’entraînement (les entraîneurs préfèrent les réponses longues qui paraissent plus complètes) et de problèmes de sur-optimisation bien connus.1, 2
  • Dans l’idéal, le modèle devrait poser des questions pour clarifier les points ambigus de la demande de l’utilisateur. En réalité, nos modèles actuels se contentent généralement de deviner l’intention de l’utilisateur.
  • Nous avons fait en sorte que le modèle refuse de répondre aux demandes inappropriées, mais il peut parfois répondre aux instructions dangereuses ou se montrer biaisé. Nous utilisons l’API Moderation⁠ pour alerter certains types de contenus dangereux ou les bloquer, mais nous nous attendons à un certain nombre de faux positifs et faux négatifs dans les premiers temps. Nous avons hâte de recueillir les commentaires de nos utilisateurs pour continuer à améliorer ce système.

Déploiement progressif

Cette version préliminaire de ChatGPT marque la dernière étape du déploiement progressif⁠ par OpenAI de systèmes d’IA toujours plus sûrs et utiles. Cette version bénéficie de mécanismes de sécurité nés des nombreuses leçons que nous avons tirées de nos modèles précédents, comme GPT‑3 et Codex. Nous avons notamment considérablement réduit les sorties dangereuses et erronées grâce à l’apprentissage par renforcement à partir de rétroaction humaine.

Comme nous l’avons mentionné précédemment, nous avons conscience que ce modèle reste sujet à de nombreuses limites ; nous prévoyons donc de le mettre à jour pour y remédier. Nous espérons qu’en rendant ChatGPT accessible, nos utilisateurs nous aiderons à repérer des problèmes dont nous n’avons pas encore connaissance.

Nous encourageons les utilisateurs à nous faire des commentaires sur les sorties problématiques du modèle via l’interface, ainsi que sur les faux positifs et faux négatifs du filtre externe, également accessible via l’interface. Nous sommes particulièrement intéressés par les sorties dangereuses susceptibles d’être générées dans des conditions réalistes, sans pièges, ainsi que les commentaires permettant de découvrir et comprendre des risques inédits et d’y apporter des solutions. Vous pouvez participer au concours de commentaires ChatGPT⁠(ouverture dans une nouvelle fenêtre)3 pour tenter de remporter jusqu’à 500 $ en crédits d’API.A Pour participer, envoyez vos commentaires via le formulaire dont le lien est indiqué dans l’interface de ChatGPT.

Nous avons hâte de tirer les leçons de cette version pour déployer des systèmes plus puissants, comme à notre habitude.

Global news partnerships : Le Monde and Prisa Media

Review completed & Altman, Brockman to continue to lead OpenIA

OpenIA annonce les nouveaux membres de son conseil d’administration

Retour en haut